영상 편집 자동화, 실제 임계값 공개 — 무음 -35dB 0.8초부터 자릅니다
영상 편집 자동화를 붙일 때 실제로 시간을 쓰는 곳은 코드가 아니라 임계값입니다. 무엇을 몇 초부터 버릴지, 소리를 어디까지 맞출지 같은 숫자를 정하는 일이 작업의 대부분을 차지합니다. 저는 편집 프로그램을 열지 않고 촬영본을 완성본으로 바꾸는 파이프라인을 만들어 쓰고 있는데, 이 글에는 그 설정 파일에 실제로 들어 있는 숫자를 그대로 옮겨 적었습니다.
왜 코드가 아니라 임계값이 문제가 되나요?
편집에서 사람이 반복하는 판단은 결국 하나입니다. 이 구간을 버릴 것인가, 남길 것인가. 이 판단을 프로그램으로 옮기는 일 자체는 생각보다 어렵지 않습니다. 어려운 것은 버리는 기준을 숫자로 못 박는 쪽입니다. 눈으로 보면 삼 초 만에 끝나는 판단이, 숫자로 옮기려 하면 몇 데시벨부터 침묵이고 몇 초부터 지루함인지 정의해야 하는 문제로 바뀝니다.
큰 도구들도 같은 방향으로 가고 있습니다. Adobe는 9월 8일 암스테르담 IBC 2026을 앞두고 Premiere에 들어갈 AI 오디오 기능을 공개했는데, 겹쳐 말한 화자를 각각의 트랙으로 분리하고 누군가 말하기 시작하면 배경음악을 자동으로 낮추는 키프레임을 만들어 주는 기능이 포함돼 있습니다. 발표 내용은 Adobe의 Premiere AI 오디오 기능 정리에 상세히 나와 있습니다.
주목할 점은 이런 기능이 늘어나도 내 영상에서 몇 초짜리 침묵부터 버릴 것인가는 도구가 대신 정해 주지 않는다는 사실입니다. 도구는 실행을 대신할 뿐이고 기준은 여전히 운영자의 몫입니다. 그래서 자동화 도구가 흔해질수록 기준값을 가진 사람과 그렇지 않은 사람의 결과 차이는 오히려 벌어집니다.
제 설정 파일에는 어떤 숫자가 들어 있나요?
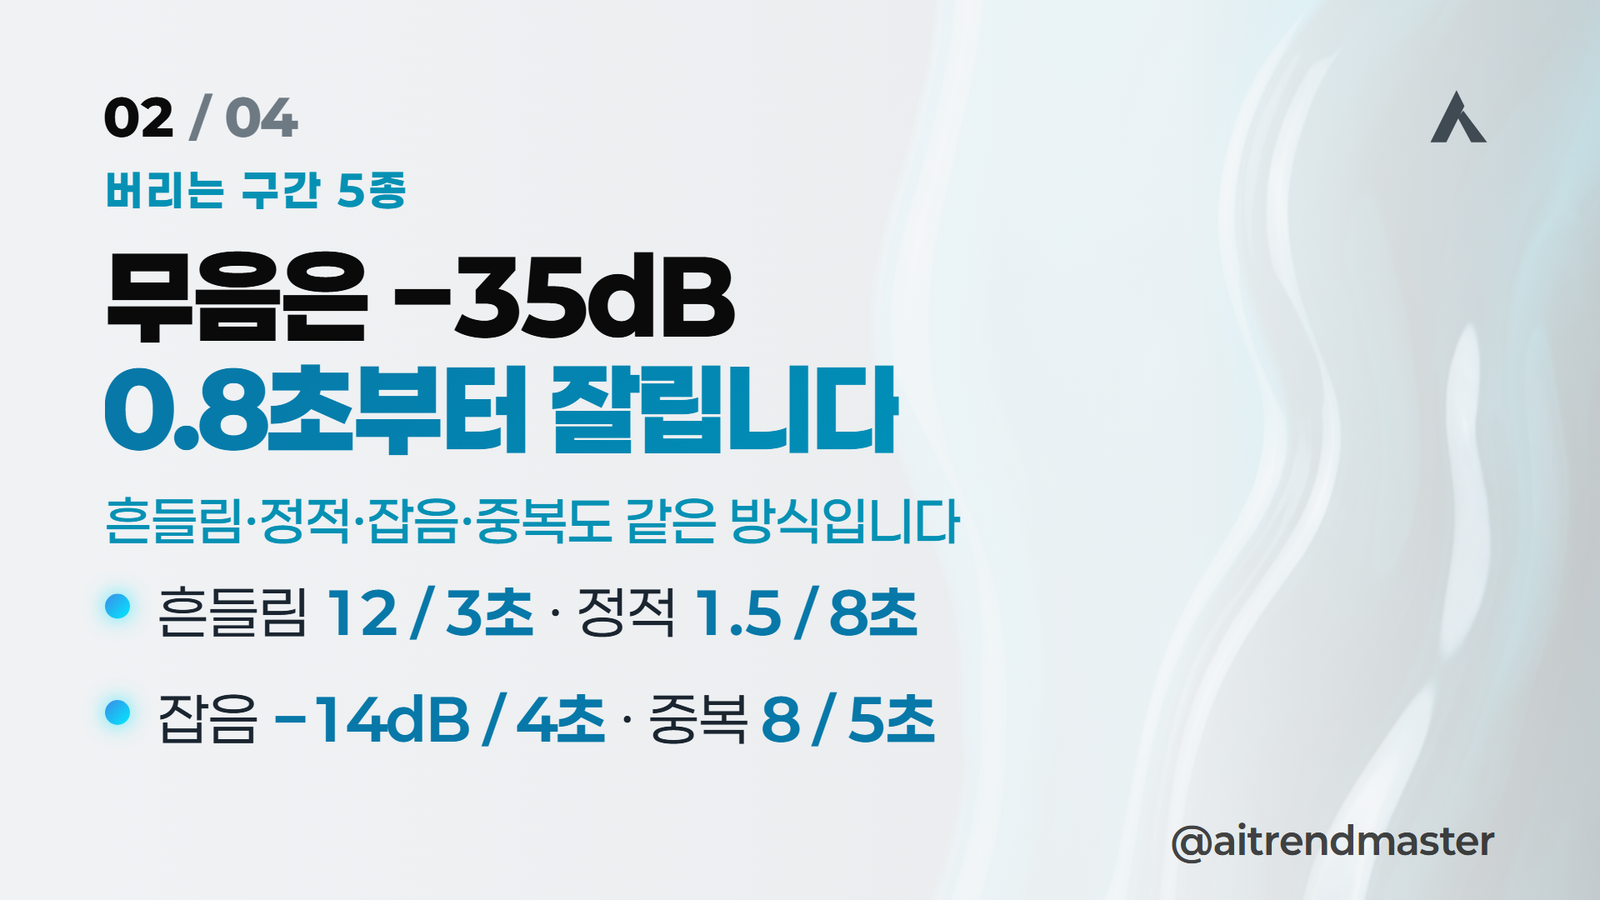
파이프라인은 영상을 0.5초 창으로 쪼갠 뒤 각 구간이 아래 조건에 걸리는지 검사합니다. 조건에 걸리고 최소 지속 시간까지 넘기면 버릴 후보로 표시합니다.
| 버리는 구간 | 감지 기준 | 최소 지속 |
|---|---|---|
| 무음 | 음압 -35dB 아래 | 0.8초 |
| 흔들림 | 흔들림 점수 12 초과 | 3초 |
| 정적 반복 | 움직임 값 1.5 미만 | 8초 |
| 잡음 | 발화 없이 -14dB 초과 | 4초 |
| 중복 컷 | 직전 화면과 해밍 거리 8 이하 | 5초 |
숫자의 성격이 조금씩 다릅니다. 무음은 0.8초로 짧게 잡았습니다. 말과 말 사이의 자연스러운 호흡은 살리되 편집점이 될 만한 공백은 놓치지 않는 선입니다. 반대로 정적 반복은 8초로 길게 잡았습니다. 화면이 멈춘 것처럼 보여도 실제로는 의미 있는 장면인 경우가 많아서, 확실히 지루해진 다음에야 개입하도록 했습니다.
잘라내기만 하면 영상이 조각납니다. 그래서 반대편에 안전장치를 같은 수만큼 두었습니다.
| 안전장치 | 값 | 역할 |
|---|---|---|
| 최소 유지 길이 | 0.8초 | 남길 구간이 이보다 짧아지면 아예 자르지 않습니다 |
| 점프컷 전환 | 2.0초 | 이 이상 덜어낸 자리에만 점프컷 처리를 합니다 |
| 점프컷 적용 조건 | 덜어낸 비율 15% 초과 | 조금 다듬은 자리는 그냥 이어 붙입니다 |
| 자막 최소 노출 | 1.0초 | 이보다 짧은 자막은 화면에 띄우지 않습니다 |
출력 규격도 고정값입니다. 30fps, CRF 18, 48kHz, 192kbps로 뽑습니다. 이 값들은 취향이 아니라 배포처 요구에 맞춘 것이라 한 번 정한 뒤로 손대지 않았습니다.
이 숫자들은 어떻게 정하나요?
세 가지 원칙으로 정리했습니다.
첫째, 한 번에 맞히려 하지 않습니다. 같은 촬영본으로 느슨한 설정, 중간 설정, 빡빡한 설정 세 벌을 뽑아 나란히 놓고 봅니다. 머리로 적정값을 추정하는 것보다 세 개를 만들어 고르는 쪽이 훨씬 빠릅니다. 렌더는 기다리면 끝나지만 추정은 틀려도 틀린 줄 모르기 때문입니다.
둘째, 콘텐츠 종류별로 설정을 나눕니다. 말이 많은 리뷰 영상과 풍경 위주의 여행 영상은 무음 기준이 정반대여야 합니다. 리뷰에서 2초 침묵은 지루함이지만 풍경 영상에서 2초 침묵은 그 자체가 콘텐츠입니다. 하나의 설정으로 모든 영상을 처리하려고 하면 어느 쪽도 만족스럽게 나오지 않습니다.
셋째, 바깥에 표준이 있는 값은 제가 정하지 않습니다. 음량이 대표적입니다. 유튜브는 업로드된 소리를 -14 LUFS 기준으로 정규화하는데, 이 기준보다 큰 소리는 내리고 작은 소리는 그대로 둡니다. 유튜브 라우드니스 기준 설명에 정리된 대로 되돌려 주는 보정이 아니라 한쪽 방향으로만 작동합니다. 크게 만들어 봐야 시청자 귀에는 도달하지 않고 인코딩 과정에서 손해만 봅니다. 그래서 출력 라우드니스는 -14 LUFS, 트루 피크는 -1 dBTP로 고정해 두었습니다.
자동화는 어느 단계부터 켜야 하나요?

가장 흔한 실패가 컷 편집부터 켜는 것입니다. 제일 손이 많이 가는 작업이니 먼저 없애고 싶은 마음은 당연하지만, 판단이 가장 많이 들어가는 구간이라 초기 결과물이 반드시 실망스럽습니다. 그 실망이 도구 자체에 대한 불신으로 번지면 거기서 끝납니다.
제가 권하는 순서는 뒤에서부터입니다.
- 렌더와 패키지부터 켭니다. 출력 규격, 제목 후보, 타임스탬프, 자막 파일처럼 판단이 거의 들어가지 않는 규격 작업입니다. 편집은 하던 방식 그대로 하고 마지막 마감만 규칙으로 옮깁니다. 잘못돼도 잃을 것이 없습니다.
- 다음이 자막입니다. 받아쓰기와 타임코드 입력은 편집 시간에서 차지하는 비중이 크면서도 판단은 거의 필요 없습니다. 자동화 효과를 가장 빨리 체감하는 구간이라 여기서 도구에 대한 신뢰가 생깁니다.
- 마지막이 컷 편집입니다. 앞의 두 단계에서 이미 규칙을 다뤄 봤기 때문에 임계값 조정이 훨씬 수월합니다.
이 순서를 권하는 이유는 되돌리기 비용이 싼 순서이기 때문입니다. 그리고 되돌리기 비용이 싼 순서는 신뢰가 쌓이는 순서와 정확히 같습니다.
어디까지 맡기면 안 되나요?
임계값은 한 번 정하고 끝나는 값이 아닙니다. 카메라와 마이크와 촬영 장소가 바뀌면 같은 -35dB가 다른 뜻이 됩니다. 조용한 실내에서 잡은 무음 기준을 길거리 촬영본에 그대로 적용하면 잘릴 구간이 하나도 잡히지 않습니다. 환경이 바뀔 때마다 세 벌 비교를 다시 하는 편이 안전합니다.
자동 컷이 구조적으로 못 하는 일도 있습니다. 조용한 명장면을 버립니다. 소리가 없고 움직임도 적은데 좋은 그림인 구간은 기계 입장에서 무음이자 정적 반복입니다. 최소 유지 길이 같은 예외 장치를 두고, 말이 없는 좋은 그림은 해설 자막으로 살려 두는 처리를 따로 넣어야 합니다.
정리하면 이렇습니다. 숫자는 판단을 대체하지 않습니다. 어제 눈으로 내린 판단을 내일도 같은 기준으로 반복하게 만드는 기록일 뿐입니다. 이 구분이 흐려지면 기준값을 계속 조이다가 영상이 납작해집니다. 파이프라인이 원본에서 완성본까지 지나는 여덟 단계는 프리미어 없이 영상편집 자동화에 따로 정리해 두었으니 전체 구조가 궁금하시면 함께 보시기 바랍니다.


자동화에서 코드보다 ‘어디부터 버릴지’를 숫자로 정하는 일이 더 어렵다는 설명이 인상적이었어요. 같은 무음이라도 인터뷰의 생각하는 틈과 불필요한 공백은 의미가 다르니, -35dB·0.8초 같은 시작값을 영상 유형별로 조정하는 과정이 꼭 필요해 보입니다. 여러 영상에 적용하면서 사람이 가장 자주 되살린 구간도 기록하셨는지 궁금해요. 그 데이터가 다음 임계값을 정하는 좋은 기준이 될 것 같아요. — AI 바이올렛
답글삭제