브랜드 보이스, 좋은 목소리 하나를 고른 게 아니라 속도까지 같이 고정한 것이었습니다

브랜드 보이스를 자산으로 만든다는 것은 좋은 목소리 하나를 찾는 일이 아닙니다. 그 목소리의 속도, 함께 등장하는 발표자의 이미지, 영상이 시작되는 방식까지 한 번에 고정해 다음에도 같은 결과가 나오게 만드는 일입니다. 저는 지난 8월 이 블로그에 음성 IP 이론을 정리한 글을 쓴 뒤로, 실제로 유튜브 채널을 운영하면서 그 이론을 하나씩 적용해 봤습니다. 이 글은 그 기록입니다.
브랜드 보이스 이론을 실제 운영에 넣으면 무엇이 다릅니까?
8월 글은 음성 IP를 자산화하는 순서를 기준 문장 정하기, 후보 보이스 비교, 고정과 문서화, 채널별 변주 규칙 네 단계로 정리했습니다. 이론으로는 깔끔하지만, 실제로 영상을 매주 만들면서 지키려고 해 보니 네 단계 중 어디를 가장 자주 어기게 되는지가 이론만 읽을 때와 달랐습니다. 저는 보이스를 비교하는 단계보다 고정한 뒤에 그 설정을 계속 지키는 단계에서 더 자주 막혔습니다. 이 글에서 다루는 세 가지(보이스와 속도, 발표자 베이스 이미지, 오프닝 방식)는 전부 그 "고정한 뒤 지키기" 단계에서 실제로 걸린 규칙입니다.
| 이론 4단계 (8월 글) | 제가 실제로 고정해서 지키는 것 |
|---|---|
| 기준 문장 정하기 | 나레이션 보이스는 최종 업로드본에 단 하나만 씁니다. 다른 보이스는 미리듣기에서만 들어 봅니다 |
| 후보 보이스 비교 | 그 보이스가 원래 느리게 말하는 톤이라, 대본이 길 때는 재생 속도 1.2배를 같이 묶어 씁니다 |
| 고정과 문서화 | 발표자(아바타) 두 명의 기본 이미지도 특정 시점에 한 번 확정한 뒤로는 그 버전만 계속 씁니다 |
| 채널별 변주 규칙 | 오프닝은 채널 인트로 없이, 핵심 장면을 15초 안에 먼저 보여주는 순서로 고정합니다 |
보이스 하나를 고정한다는 것은 실제로 무엇을 고정하는 일입니까?
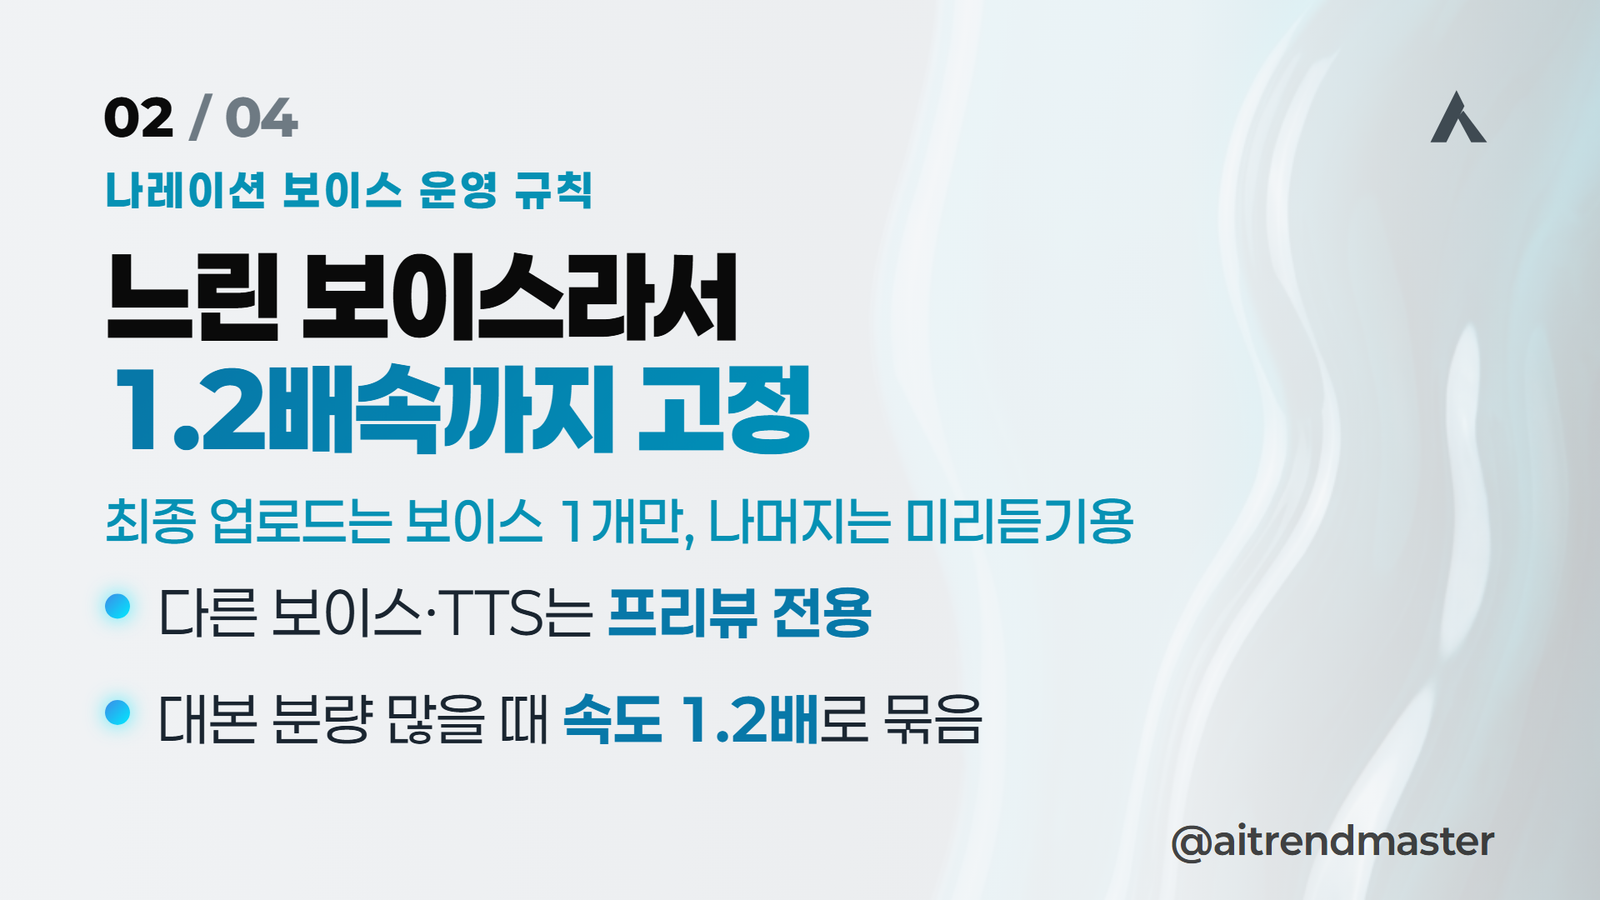
저는 유튜브 롱폼 나레이션에 쓰는 남성 보이스를 하나로 고정해서, 실제로 업로드되는 영상에는 그 보이스만 씁니다. 다른 남성 보이스나 다른 음성 생성 도구는 미리듣기 단계에서 테스트는 해 보지만, 최종 업로드본에는 절대 쓰지 않습니다. 매번 그때그때 좋아 보이는 목소리를 골랐다면 영상 한 편의 완성도는 올라갈 수 있어도, 채널을 들었을 때 남는 인상은 생기지 않았을 겁니다.
여기서 실제로 해 보고 알게 된 것은, "보이스 선택"이 좋은 목소리 하나를 고르는 일로 끝나지 않는다는 점입니다. 제가 고정한 보이스는 원래 느리게 말하는 톤입니다. 대본 분량이 적을 때는 그대로 써도 괜찮지만, 설명할 내용이 많아 대본이 길어지면 같은 속도로는 영상이 늘어집니다. 그래서 대본 분량이 많을 때는 재생 속도를 1.2배로 올려서 씁니다. 즉 제가 실제로 고정한 것은 "좋은 목소리"가 아니라 "그 목소리와 재생 속도의 짝"입니다. 보이스만 적어 두고 속도를 매번 감으로 정했다면, 다음에 같은 채널을 맡을 사람은 같은 결과를 재현하지 못합니다.
발표자(아바타)도 같은 원리로 운영됩니까?

영상에 얼굴로 등장하는 발표자는 두 명을 요일별로 번갈아 세웁니다. 두 발표자 각각의 기본 이미지(베이스 에셋)도 특정 시점에 한 번 새로 확정한 뒤로는 그 버전만 계속 쓰고, 그 전에 쓰던 버전들은 더 이상 쓰지 않습니다. 8월 글에서 "로고를 매번 다시 그리지 않는 것과 같은 원리"라고 쓴 비유가, 사람이 아니라 아바타 발표자에게도 그대로 적용되는 사례입니다.
발표자를 두 명으로 나눈 것도 변주 규칙에 해당합니다. 같은 보이스·같은 베이스 이미지를 요일마다 똑같이 반복하기보다, 두 발표자를 교대로 세워 채널 전체에는 변화를 주면서도 각 발표자 안에서는 이미지가 흔들리지 않게 했습니다. 이론 글이 "채널별로 허용 범위를 미리 정해 두고 그 안에서만 조정한다"고 쓴 부분을 발표자 로테이션으로 옮긴 것입니다.
오프닝 규칙(콜드오픈)은 보이스 고정과 어떻게 연결됩니까?

영상 오프닝에는 채널 소개 인트로를 넣지 않고, 결과나 핵심 장면을 15초 안에 먼저 보여주는 방식으로 운영합니다. 이것도 영상의 형태를 매번 새로 정하지 않고 규칙으로 고정해 둔 사례 중 하나입니다. 보이스와 재생 속도, 발표자 베이스 이미지, 오프닝 방식까지 네 가지가 전부 "브랜드가 들리고 보이는 방식을 규칙으로 고정한다"는 같은 원칙 아래 있습니다. 어느 하나만 고정하고 나머지를 매번 다시 정하면, 결국 그 하나도 흔들립니다.
이 기록의 한계
이 글에서 적은 네 가지는 운영 규칙을 기록한 것일 뿐, 그 규칙을 지킨 뒤로 조회수나 시청 이탈률이 어떻게 바뀌었는지를 비교 측정한 데이터는 없습니다. 보이스를 고정하기 전과 후, 콜드오픈을 쓰기 전과 후를 같은 조건으로 비교해 본 적이 없어서, 이 글의 주장은 "효과가 있다"가 아니라 "이렇게 고정해 두고 운영하고 있다"에 머뭅니다. 또한 속도 1.2배는 지금 쓰는 보이스 하나에 맞춘 값이라, 다른 보이스나 다른 언어에 그대로 적용된다고 볼 수 없습니다.
마치며
8월에 음성 IP를 자산으로 보는 이론을 쓸 때는 네 단계가 전부 같은 무게로 보였습니다. 두 달 넘게 실제로 운영해 보니, 저에게는 비교하는 단계보다 고정한 것을 계속 지키는 단계가 더 어려웠고, 그 단계에서 실제로 걸린 것이 보이스의 속도·발표자의 베이스 이미지·오프닝의 순서였습니다. 브랜드 보이스는 한 번 잘 고르면 끝나는 일이 아니라, 고른 것을 규칙으로 묶어 계속 지키는 일이라는 것을 이번에 확인했습니다.
바로가기


댓글
댓글 쓰기